-
LLMLingua-2: 작은 인코더로 3,003토큰을 970토큰으로 줄인 방법IT 이야기 2026. 10. 19. 09:00
문장을 다시 쓰지 않고 남길 단어를 고르는 압축 모델의 성과와 한계
질문은 “무엇을 남길까요?”입니다
긴 문서를 AI에 전달할 때 비용을 낮추는 한 방법은 입력부터 줄이는 것입니다. 그러나 문장 요약은 작은 날짜나 예외 조건을 빠뜨릴 수 있고, 문장을 새로 만들면 원문에 없던 내용이 들어갈 수도 있습니다. LLMLingua-2가 택한 문제는 더 좁습니다. 원래 단어 중 무엇을 남길지 판단하는 일을 작은 인코더에게 맡깁니다. 이 논문의 핵심은 대형 생성 모델을 그대로 복제하는 데 있지 않습니다. 프롬프트 압축이라는 작업을 별도의 분류 문제로 설계했다는 점에 있습니다.
연구에서 실제로 한 일
연구진은 MeetingBank 회의록을 작은 조각으로 나누고 GPT-4에 불필요한 단어만 삭제하도록 지시했습니다. 결과와 원문을 맞춰 각 단어에 보존·삭제 라벨을 붙이고, 새 단어가 많이 생기거나 정렬 품질이 낮은 사례는 걸러냈습니다. 이 데이터로 XLM-RoBERTa-large 또는 mBERT 기반 분류기를 학습했습니다. 추론 때는 양방향 문맥을 읽어 보존 확률을 계산하고, 정해진 예산만큼 단어를 원래 순서대로 남깁니다. 여러 토큰으로 나뉜 단어는 묶어서 처리합니다. 질문에 맞춰 매번 다른 내용을 고르는 방식이 아니라, 다양한 후속 작업에서 쓸 압축본을 만드는 설계입니다.
Table 1: 길이와 정확도를 함께 읽기
원문 Table 1은 MeetingBank에서 압축 결과를 GPT-3.5-Turbo-0613에 전달한 실험입니다. 행은 압축 방법, 열은 QA의 EM, 요약 지표, 평균 토큰 수와 압축 배수입니다. EM은 정답과 완전히 일치한 비율로 높을수록 좋습니다. LLMLingua-2는 3,003토큰을 970토큰으로 줄이면서 EM 86.92를 기록했습니다. 원본 입력의 87.75보다 0.83점 낮습니다. 작은 버전은 984토큰, EM 85.82였습니다. 따라서 “성능 손실이 전혀 없다”보다 “이 회의록 평가에서 길이를 약 3분의 1로 줄이며 QA 성능 대부분을 유지했다”가 정확합니다. 요약도 지표마다 움직임이 달라 한 열의 상승을 전체 품질 향상으로 읽으면 안 됩니다.
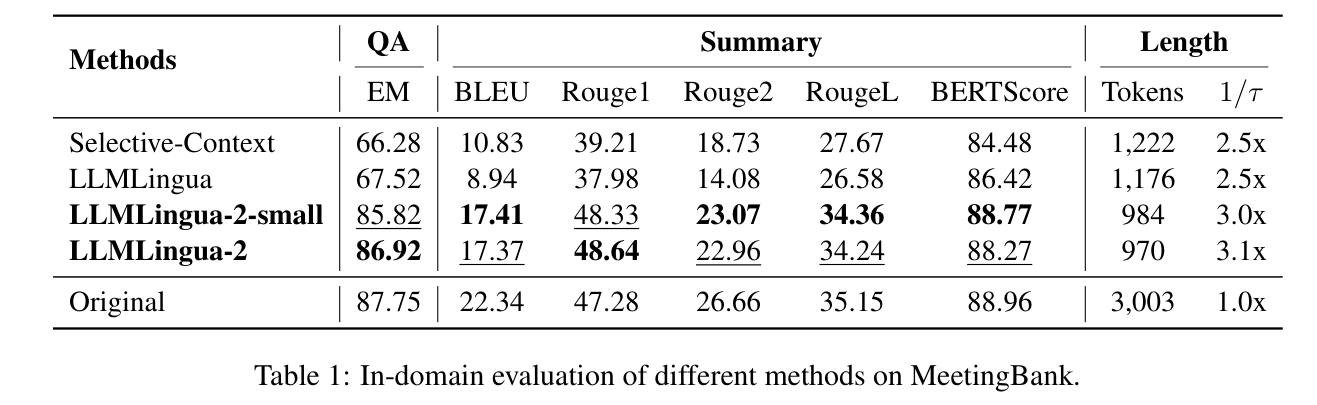
MeetingBank의 QA·요약·길이 비교. QA EM은 높을수록 좋고 Tokens는 평균 입력 토큰 수, 1/τ는 원본/압축 길이 배수입니다. GPT-3.5-Turbo-0613, greedy decoding, temperature 0 조건. 압축률은 방법별로 완전히 같지 않습니다. Pan et al. (2024), Table 1, PDF 6쪽(인쇄 968쪽). ©2024 Association for Computational Linguistics. CC BY 4.0. 출처: https://aclanthology.org/2024.findings-acl.57/ ; 라이선스: https://creativecommons.org/licenses/by/4.0/ . 원본 도표 영역을 캡처·여백 절단·크기 조정했으며 데이터·표기는 변경하지 않았습니다. Table 5: 압축 시간과 총시간은 다릅니다
Table 5의 단위는 초입니다. 5배 압축 조건에서 압축기 자체는 0.4초, 압축과 모델 요청을 합친 시간은 5.2초였습니다. 압축하지 않은 14.9초와 비교하면 논문 표기의 약 2.9배 가속입니다. 2배 압축에서는 총 9.4초로 개선 폭이 작습니다. 입력 토큰이 5분의 1이 됐다고 전체 요청도 5배 빨라지는 것은 아닙니다. 모델 응답 시간과 압축 비용이 함께 남기 때문입니다. 이 수치는 V100 32GB 환경의 MeetingBank 측정이며, 다른 하드웨어나 API의 현재 응답 시간을 보장하지 않습니다.
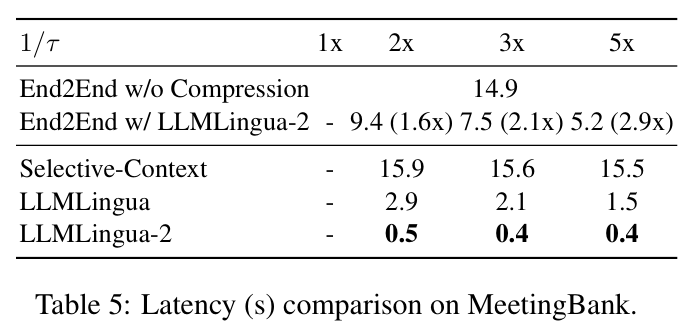
MeetingBank 지연시간 비교. 열은 원본/압축 길이 배수, 숫자의 단위는 초이며 낮을수록 빠르다. 위쪽은 전체 요청, 아래쪽은 압축기 자체 시간입니다. V100 32GB 조건. Pan et al. (2024), Table 5, PDF 8쪽(인쇄 970쪽). ©2024 Association for Computational Linguistics. CC BY 4.0. 출처: https://aclanthology.org/2024.findings-acl.57/ ; 라이선스: https://creativecommons.org/licenses/by/4.0/ . 원본 도표 영역을 캡처·여백 절단·크기 조정했으며 데이터·표기는 변경하지 않았습니다. 일반화 결과에는 경계선이 있습니다
학습에 쓰지 않은 LongBench의 2,000토큰 제약에서 LLMLingua-2 평균 점수는 39.1, 원본은 44.0이었습니다. 질문을 이용하는 LongLLMLingua는 같은 표에서 48.0입니다. 작업과 무관하게 압축한 결과를 재사용하기 쉽다는 장점에는 질문별 중요도를 미리 알지 못한다는 대가가 따릅니다. MeetingBank QA의 문답과 요약 기준에는 GPT-4 생성 결과도 사용됐습니다. 사람 평가나 모든 실무 문서에 대한 검증으로 넓혀 말할 수 없습니다. 단어를 새로 만들지 않는다는 특성도 부정어·조건을 삭제했을 때의 의미 변화를 막아 주지는 않습니다.
삭제 라벨을 만드는 과정도 모델의 일부입니다
논문의 학습 자료는 사람이 정답 단어를 하나씩 표시한 데이터가 아닙니다. 생성 모델이 만든 압축문을 원문과 대조해 라벨로 바꾼 자료입니다. 연구진은 먼저 512토큰 이내에서 마침표로 끝나는 조각을 만들어 GPT-4에 전달했습니다. 긴 회의록 전체를 한 번에 압축하면 출력 길이 제한과 지나친 삭제가 겹칠 수 있기 때문입니다. 여기서 조각 길이와 최종 압축 토큰 예산은 서로 다른 설정입니다.
GPT-4에 단어를 추가하거나 순서를 바꾸지 말라고 지시해도 결과가 언제나 그대로 나오지는 않았습니다. 같은 단어가 여러 번 나오는 경우에는 어느 위치를 남긴 것인지 정렬하기 어렵고, 복수형이나 시제만 바뀐 단어도 생깁니다. 논문은 이런 모호함을 처리하는 정렬 알고리즘을 사용합니다. 좋은 압축문을 생성하는 문제와 신뢰할 수 있는 보존 라벨을 얻는 문제를 따로 해결한 셈입니다.
품질 필터는 원문에 없는 단어의 비율인 Variation Rate와 정렬 상태를 나타내는 Alignment Gap을 사용합니다. 각각 값이 높은 상위 5%, 상위 10% 사례를 제외했습니다. 이는 데이터 구축상의 필터 조건이지, 남은 자료에 오류가 전혀 없다는 인증이 아닙니다. 학습 라벨의 품질이 압축기의 선택에 영향을 준다는 점까지 함께 읽어야 작은 인코더의 성과가 어디에서 왔는지 설명할 수 있습니다.
단어 점수는 최종 답의 중요도와 같지 않습니다
학습된 인코더는 각 위치에 보존과 삭제의 두 확률을 출력합니다. 목표 길이를 정한 다음 보존 확률이 높은 단어를 선택하고 원래 순서로 되돌립니다. 한 단어가 여러 서브워드로 분해되면 그 확률을 평균 내어 단어의 완전성을 유지합니다. 앞 문맥만 보는 생성 모델의 예측 난도를 사용하던 방식과 달리, 양쪽 문맥을 읽고 압축 목적을 직접 학습한 분류 확률을 사용한다는 것이 설계상의 차이입니다.
이 확률은 어떤 미래 질문에도 필요한 정보가 남을 확률이라고 검증된 값은 아닙니다. 예를 들어 반복되는 회의 진행 표현을 지우는 판단과, 짧게 한 번 등장하는 예외 조건을 지우는 판단은 후속 업무에서 다른 영향을 줍니다. 이는 적용상 가능한 실패를 설명하는 예시이며 논문이 해당 한국어 회의록을 시험했다는 뜻은 아닙니다. 삭제형이라는 형식과 의미 보존이라는 결과를 구분해야 합니다.
이런 점에서 LLMLingua-2는 큰 언어모델의 축소판보다 특정 전처리 작업을 맡는 작은 모델로 이해하는 편이 정확합니다. 압축기는 입력을 고르고, 별도의 답변 모델이 그 입력으로 답을 만듭니다. 압축기 매개변수가 작다는 사실만으로 답변 모델의 메모리나 호출 비용까지 모두 작아지는 것은 아닙니다. 두 모델과 전처리 시간을 합친 시스템을 평가해야 합니다.
Table 2에서 질문 없는 압축의 대가 확인하기
추가한 Table 2는 학습 도메인 밖의 긴 문맥 평가를 보여 줍니다. LongBench에는 단일·다중 문서 QA, 요약, 소수 예시 학습, 합성 과제와 코드가 섞여 있습니다. 평균 열은 이 서로 다른 평가 점수를 묶은 값입니다. 2,000토큰 제약에서 LLMLingua-2의 평균 입력은 1,954토큰이고 LongLLMLingua는 1,809토큰이므로, 이름에 같은 예산이 붙었다고 실제 길이까지 일치하는 대조 실험은 아닙니다.
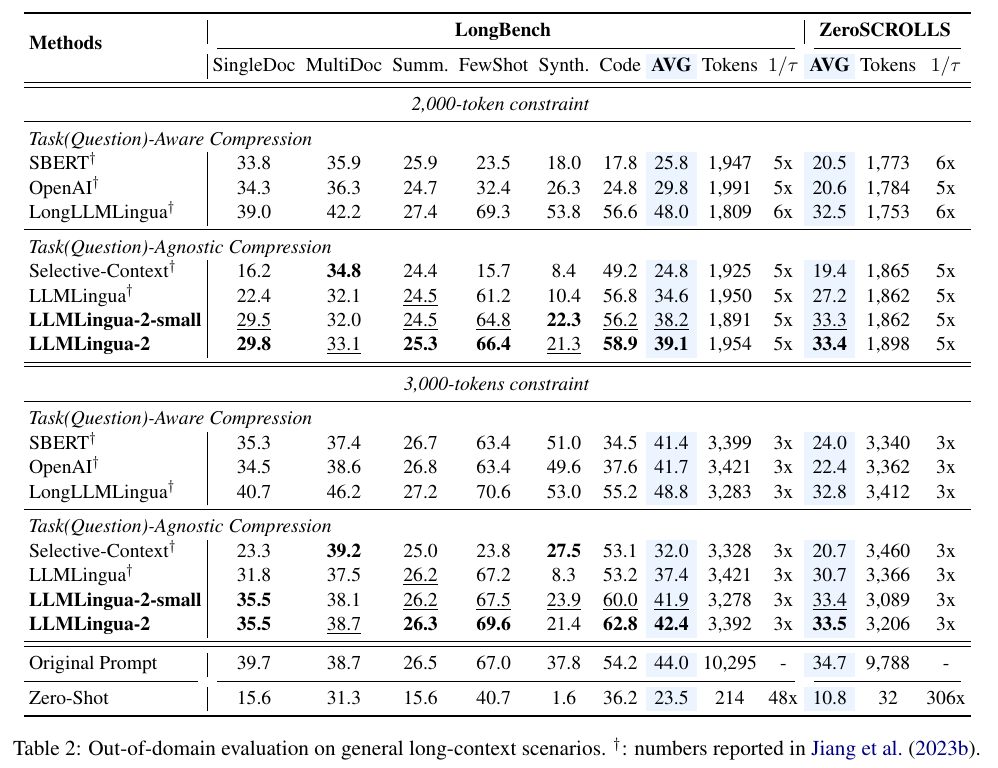
LongBench·ZeroSCROLLS의 학습 도메인 외 평가. 행은 방법, 열은 과제별 점수·평균 입력 토큰·압축 배수입니다. 2,000과3,000토큰 제약을 구분하며 평균값은 공통 정답률이 아닙니다. Pan et al. (2024), Table 2, PDF 7쪽(인쇄 969쪽). ©2024 Association for Computational Linguistics. CC BY 4.0. 출처: https://aclanthology.org/2024.findings-acl.57/ ; 라이선스: https://creativecommons.org/licenses/by/4.0/ . 원본 도표 영역을 캡처·여백 절단·크기 조정했으며 데이터·표기는 변경하지 않았습니다. 또한 표의 LongLLMLingua에는 기존 연구에서 가져온 수치라는 표시가 있습니다. 이 논문의 MeetingBank 표와 다른 논문의 같은 이름 행을 하나의 실험처럼 이어 붙이면 안 됩니다. 질문을 이용하는 집단과 이용하지 않는 집단, 2,000과 3,000토큰 구간을 각각 나눠 읽는 것이 우선입니다. 원본보다 평균 점수가 낮은 결과도 함께 드러내야 질문 독립적 압축의 장점과 손실을 균형 있게 볼 수 있습니다.
운영 실험에서는 압축본 하나를 여러 질문에 재사용할 때의 이득과 중요한 세부사항이 빠지는 비용을 함께 기록할 수 있습니다. 압축 전후 토큰 수, 압축 처리 시간, 모델 응답 시간, 질문별 정답과 근거 보존을 같은 행에 놓는 방식입니다. 평균 점수가 유지돼도 특정 날짜나 부정 표현을 묻는 질문에서만 실패할 수 있으므로, 전체 평균과 정보 유형별 결과를 분리하는 것이 이 연구에서 끌어낼 만한 실무적 검증 과제입니다.
해석과 적용 제안
이 연구를 실무에 옮긴다면 “가장 작은 압축본”보다 “업무상 잃으면 안 되는 정보”부터 정하는 편이 낫습니다. 예를 들어 회의록에서는 담당자, 날짜, 취소 조건을 별도로 확인하고 원본 입력·압축 입력의 답을 같은 질문 묶음으로 비교할 수 있습니다. 이는 논문이 실시한 현장 실험이 아니라 이 글의 적용 제안입니다. 같은 문서에 여러 질문을 던지는 서비스라면 재사용 가능한 압축본의 장점을 시험하되, 작은 모델이 삭제한 내용을 큰 모델이 복구해 줄 것이라고 기대하지 않는 것이 안전합니다.
참고문헌
Pan, Z., Wu, Q., Jiang, H., Xia, M., Luo, X., Zhang, J., Lin, Q., Rühle, V., Yang, Y., Lin, C.-Y., Zhao, H. V., Qiu, L., & Zhang, D. (2024). LLMLingua-2: Data distillation for efficient and faithful task-agnostic prompt compression. In L.-W. Ku, A. Martins, & V. Srikumar (Eds.), Findings of the Association for Computational Linguistics: ACL 2024 (pp. 963–981). Association for Computational Linguistics. https://doi.org/10.18653/v1/2024.findings-acl.57
반응형'IT 이야기' 카테고리의 다른 글
Adaptive-RAG: 6천만 매개변수 분류기로 검색 횟수를 고를 수 있을까요? (0) 2026.10.20 LongLLMLingua: 1만 토큰을 줄일 때 질문부터 봐야 하는 이유 (0) 2026.10.19 DistiLLM 논문 리뷰: 학생이 만든 답을 재사용해 증류 학습 비용 줄이기 (0) 2026.10.18 Layer-Condensed KV Cache 논문 리뷰: 층의 기억을 공유할 때 얻는 처리량과 학습 비용 (0) 2026.10.18 SparseGPT 논문 리뷰: 가중치 절반을 지우는 정확도와 실제 가속의 조건 (0) 2026.10.17