-
DistiLLM 논문 리뷰: 학생이 만든 답을 재사용해 증류 학습 비용 줄이기IT 이야기 2026. 10. 18. 18:00
작은 언어모델을 가르칠 때 큰 교사의 답을 따라 하게 하는 증류는 유용하지만, 학생이 학습 중 보는 문장과 실제 생성할 문장이 다르면 문제가 생깁니다. 학생이 직접 만든 답으로 학습하면 그 차이를 줄일 수 있지만 매번 생성하는 비용이 커집니다. DistiLLM은 확률 분포를 비교하는 손실과 생성 데이터를 쓰는 방법을 함께 바꾸어, 품질과 증류 학습 시간을 조절하는 연구입니다.
모델의 추론 비용과 증류 비용은 다르다
이 글은 ICML 2024 논문의 arXiv v2를 대상으로 합니다. 큰 교사 모델의 확률 분포를 작은 학생 모델이 따라가도록 학습한다는 기본 틀은 유지합니다. 이 연구가 특히 줄이려는 것은 학생을 만드는 증류 과정의 비용입니다. 이미 만들어진 같은 학생 모델이 답을 생성하는 속도가 손실 함수 변경만으로 몇 배 빨라졌다는 뜻은 아닙니다.
고정된 데이터만 쓰면 학생이 실제 추론 중 만들 법한 문맥을 충분히 경험하지 못할 수 있습니다. 반대로 매번 학생 생성 결과인 SGO를 만들면 생성 시간이 반복해서 듭니다. 교사도 학생의 어색하거나 틀린 답에 적절한 확률 신호를 주지 못할 수 있습니다. 따라서 SGO를 많이 쓰는 것과 효과적으로 쓰는 것은 같은 목표가 아닙니다.
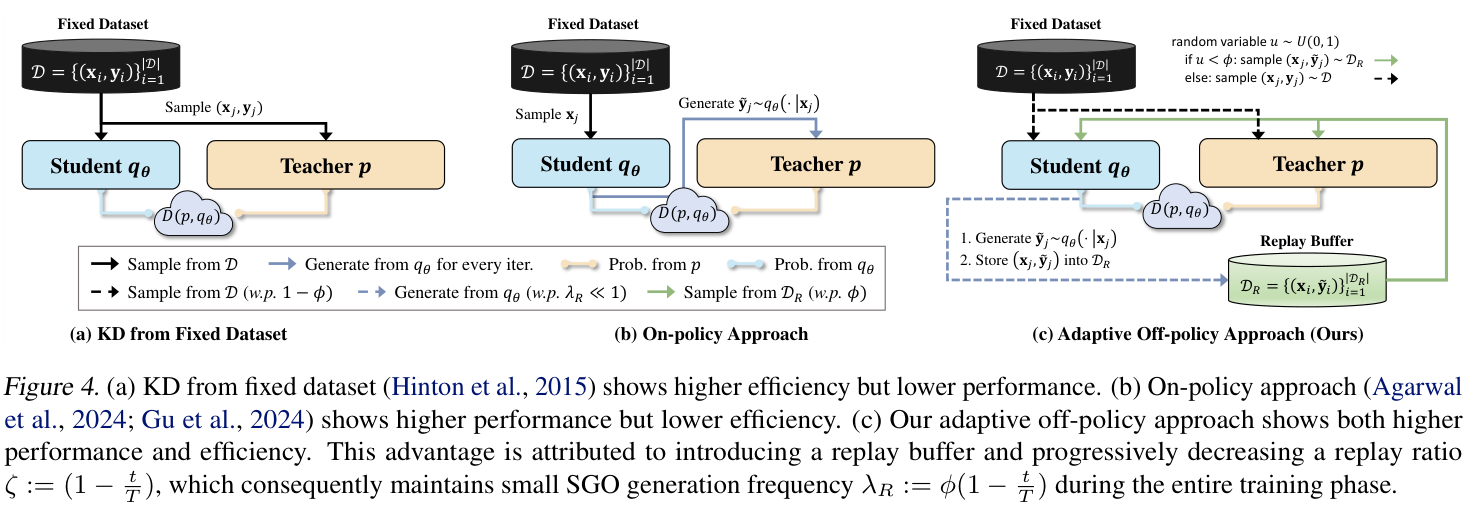
원문 Figure 4, PDF 5쪽. 고정 데이터·매번 생성하는 on-policy·replay buffer를 이용한 adaptive off-policy 흐름 비교. 화살표와 확률 표기, 원문 캡션 전체 유지. 출처: Ko, J., Kim, S., Chen, T., & Yun, S.-Y. (2024). DistiLLM: Towards streamlined distillation for large language models (Version 2) [Preprint]. arXiv. https://arxiv.org/abs/2402.03898v2 · CC BY 4.0, https://creativecommons.org/licenses/by/4.0/ · 원문 영역 캡처(여백만 제외), 내용 변경 없음. 고정 데이터·on-policy·off-policy의 차이
Figure 4의 첫 구성은 고정 데이터에서 학습 표본을 가져옵니다. 두 번째 on-policy 구성은 현재 학생으로 새 답을 계속 생성합니다. 제안 방식은 학생이 만든 답을 replay buffer에 보관했다가 다시 뽑아 씁니다. 생성하는 빈도와 이미 생성한 답을 학습에 쓰는 빈도를 나눔으로써, 매 단계 새 답을 만드는 비용을 줄입니다.
이때 과거 학생이 만든 문장은 현재 학생의 분포와 다를 수 있습니다. 무작정 오래된 표본을 반복하면 편향이 커질 수 있다는 뜻입니다. 논문은 학습 초기에 현재 학생의 표본을 비교적 자주 갱신하고, 수렴에 가까운 후반에는 저장된 표본을 더 재사용하도록 설계합니다. 메모리 버퍼만 붙이면 어떤 증류 방법에서도 같은 이득을 얻는다는 주장은 아닙니다.
분포 사이를 조금 섞는 skew 손실
일반 KLD는 교사가 가능하다고 본 영역에서 학생 확률이 거의 0이면 최적화가 불안정할 수 있습니다. 논문의 SKL은 교사 분포 p를 학생 q와 곧바로 비교하기보다, αp+(1−α)q라는 혼합 분포와 비교합니다. SRKL은 반대 방향의 비교에도 혼합을 적용합니다. 예측 확률을 약간 섞어 분포 간 극단적인 차이의 영향을 완화하려는 선택입니다.
α를 크게 하면 모든 문제가 사라지는 것도 아닙니다. 혼합은 기울기 크기까지 바꾸므로 안정성과 학습 신호 사이의 균형이 필요합니다. 논문은 추정 오차와 기울기를 분석하고, 주요 제거 실험에서 α=0.1을 사용합니다. 이 리뷰는 증명 전체를 독립적으로 검증했다고 주장하지 않으며, 이론의 조건부 분석을 모든 생성 과제에서의 정답률 보장으로 바꾸지 않습니다.
적응형 생성 비율은 무엇을 보고 바뀌는가
SGO를 학습에 사용하는 확률 ϕ는 낮게 시작하며, 학생의 검증 손실 변화를 보고 조정합니다. 검증 손실이 이전 값보다 허용치 이상 증가하면 ϕ를 높여 고정 데이터만 보는 상황을 완화하려는 방식입니다. 새 SGO를 만드는 확률은 ϕ에 학습 진행에 따라 작아지는 비율을 곱해 정합니다. ‘저장 표본을 쓰는 확률’과 ‘새 표본을 생성하는 확률’이 서로 다릅니다.
주요 실험은 초기 ϕ를 0, replay buffer 크기를 1,000으로 두고 SRKL을 사용합니다. 버퍼가 가득 차면 오래된 표본을 새 표본으로 교체합니다. 이 설정은 생성 비용과 오래된 데이터의 편향을 절충합니다. 최적의 비율을 고정해서 전제하기보다 검증 손실로 조정하지만, 그 검증 자료가 서비스 입력을 얼마나 대표하는지는 별도로 남는 문제입니다.

원문 Figure 5, PDF 6쪽. 세 모델 계열의 지시 수행 결과와 학습 속도. 레이더 축의 R-L은 ROUGE-L, GPT4는 평가 피드백이므로 축별 수치를 같은 단위처럼 비교하지 않는다. 오른쪽은 A100 4장에서 배치 크기 4일 때 초당 처리 배치 수이며 상대 학습시간이나 추론 속도가 아니다. 출처: Ko, J., Kim, S., Chen, T., & Yun, S.-Y. (2024). DistiLLM: Towards streamlined distillation for large language models (Version 2) [Preprint]. arXiv. https://arxiv.org/abs/2402.03898v2 · CC BY 4.0, https://creativecommons.org/licenses/by/4.0/ · 원문 영역 캡처(여백만 제외), 내용 변경 없음. 평가 대상과 비교군의 조건
지시 수행 학습은 databricks-dolly-15k에서 14,000개를 학습에 쓰고 검증·시험에 각각 500개를 남깁니다. 평가는 Dolly Eval, Self-Instruct, Vicuna Eval, Super-Natural Instructions, Unnatural Instructions의 다섯 묶음입니다. ROUGE-L과 GPT-4 피드백을 사용하며, 실험에는 OpenWebText의 언어모델링 손실도 함께 더합니다. 제안된 증류 손실 하나만으로 모든 설정이 끝난다고 소개해서는 안 됩니다.
Figure 5는 GPT-2 XL 1.5B에서 GPT-2 0.1B로, OPT-2.7B에서 OPT-1.3B로, OpenLLaMA2-7B에서 3B로 옮기는 서로 다른 교사·학생 쌍을 보여 줍니다. 큰 학생 쪽은 LoRA를 이용해 학습합니다. 학습 속도 비교는 A100 네 장에서 얻은 결과입니다. 가족·크기·적응 방식이 다른 실험을 모두 같은 모델의 반복 측정처럼 해석하지 않아야 합니다.
비교군에는 고정 데이터의 KLD, 교사 생성문을 쓰는 SeqKD, 학생 생성문을 쓰는 ImitKD, MiniLLM, GKD 등이 있습니다. 이들은 손실뿐 아니라 생성과 학습의 구성도 다릅니다. 논문이 제안하는 전체 방법과 손실 하나의 효과를 구분하려면, 전체 방법 비교와 구성 요소 제거 실험을 나누어 보아야 합니다.
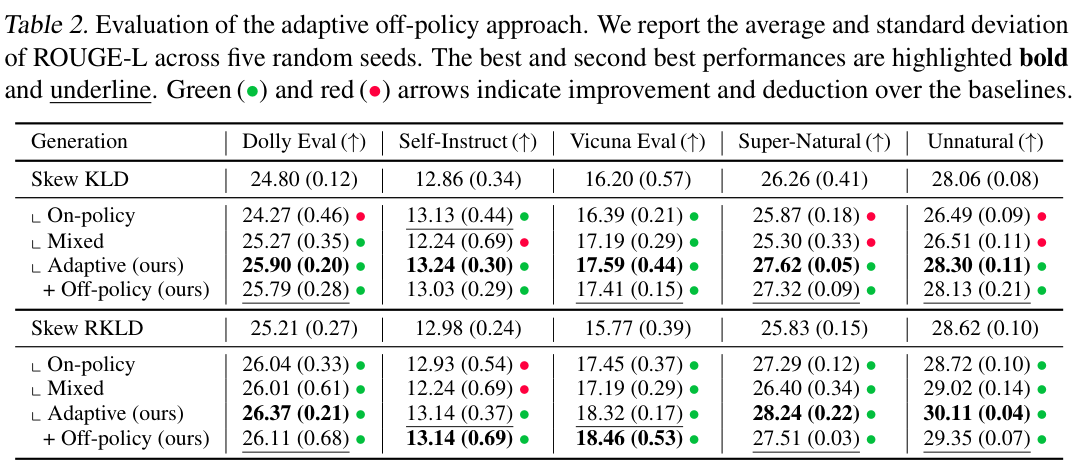
원문 Table 2, PDF 7쪽. 다섯 지시 수행 평가의 ROUGE-L 평균(표준편차), 시드 5회. 높은 값이 좋으며 굵게·밑줄·색상 표시의 뜻은 원문 캡션에 보존했다. 출처: Ko, J., Kim, S., Chen, T., & Yun, S.-Y. (2024). DistiLLM: Towards streamlined distillation for large language models (Version 2) [Preprint]. arXiv. https://arxiv.org/abs/2402.03898v2 · CC BY 4.0, https://creativecommons.org/licenses/by/4.0/ · 원문 영역 캡처(여백만 제외), 내용 변경 없음. 재사용으로 얻는 이득과 잃는 점수
Table 2는 GPT-2 XL에서 GPT-2로의 실험에서 적응형 전략과 off-policy 재사용을 비교합니다. 수치는 다섯 seed의 ROUGE-L 평균과 표준편차입니다. SRKL에서 Dolly Eval은 적응형 26.37(0.21), 재사용을 더하면 26.11(0.68)입니다. Self-Instruct는 두 방식 모두 13.14이지만 표준편차가 다르고, Vicuna Eval은 18.32에서 18.46으로 조금 높습니다.
모든 평가의 점수가 유지되는 것은 아닙니다. 같은 SRKL 행에서 Super-Natural은 28.24에서 27.51, Unnatural은 30.11에서 29.35로 낮아집니다. 재사용이 학습 시간을 줄이면서 일부 품질을 내주는 절충을 보여 주는 결과입니다. 표준편차가 주어졌다는 사실만으로 모든 차이가 통계적으로 유의하다거나 무시해도 된다고 판정할 수는 없습니다.
ROUGE-L은 참조 답과의 텍스트 중첩을 보는 지표입니다. 사실 정확성이나 도움이 되는 정도를 완전히 대변하지 못한다는 것은 이 리뷰의 평가상 해석입니다. GPT-4 피드백 역시 별도의 평가 신호이지 사람 판단 전체를 대신하는 보편 정답이 아닙니다. 서로 다른 평가가 같은 방향인지 확인하고, 실제 서비스에 필요한 오류 유형은 따로 검토할 필요가 있습니다.
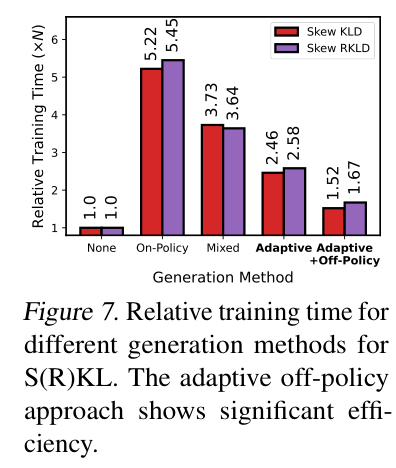
원문 Figure 7, PDF 7쪽. 세로축은 상대 학습시간(고정 데이터 기준 1), 가로축은 생성 방법. Skew KLD와 Skew RKLD의 학습 비용이며 추론 지연시간이 아니다. 출처: Ko, J., Kim, S., Chen, T., & Yun, S.-Y. (2024). DistiLLM: Towards streamlined distillation for large language models (Version 2) [Preprint]. arXiv. https://arxiv.org/abs/2402.03898v2 · CC BY 4.0, https://creativecommons.org/licenses/by/4.0/ · 원문 영역 캡처(여백만 제외), 내용 변경 없음. 상대 학습 시간 5.45와 1.67의 의미
Figure 7의 세로축은 고정 데이터 학습 시간을 1로 놓은 상대 시간입니다. SRKL은 매번 생성하는 on-policy에서 5.45, 적응형에서는 3.64, 적응형에 off-policy를 더하면 1.67입니다. 따라서 on-policy 대비 약 3.26배의 시간 비가 되지만, 고정 데이터 기준 1보다 여전히 오래 걸립니다. 학생 생성문을 쓰는 비용이 완전히 없어졌다는 결과는 아닙니다.
SKL에서도 고정 데이터 1, on-policy 5.22, 적응형과 off-policy 결합 1.52라는 차이를 보입니다. 이 그래프의 상대값을 초 단위 지연이나 tokens/s로 환산해서는 안 됩니다. 초록의 최대 4.3배와 특정 제거 실험의 5.45/1.67은 비교 설정이 다를 수 있습니다. 이 글에서는 직접 제시한 그래프의 기준과 값을 사용해 학습 비용의 교환을 설명합니다.
다른 생성 과제와 적용 범위의 한계
논문은 지시 수행 외에 SAMSum 요약과 IWSLT 2017 독일어 번역도 평가합니다. 예를 들어 요약의 T5-Base ROUGE-L은 KD 46.23에서 제안 방식 49.11로 높아집니다. 번역은 mT5 계열을 사용하고 BLEU로 평가하므로 요약 점수와 숫자를 직접 비교할 수 없습니다. 저자들도 단일 과제에서는 지시 수행보다 개선 폭이 작다고 설명합니다.
또한 기존 ImitKD·GKD에 off-policy만 적용하면 품질이 낮아지는 비교도 제시합니다. 버퍼 재사용의 효과가 손실의 수렴 특성과 결합되어 있다는 해석을 뒷받침합니다. 다른 교사·학생 쌍이나 전문 분야에 적용할 때에는 α, 생성 비율, 버퍼 크기와 평가 자료를 함께 확인해야 합니다. 학습 데이터·모델의 사용 허용 범위 역시 논문 도표의 재사용 라이선스와 별개입니다.
실무에서는 같은 학생과 같은 계산 예산에서 고정 데이터, 새로 생성하는 방식, 재사용 방식을 비교할 수 있습니다. 이어 총 학습 시간에 생성·교사 평가·학생 갱신을 모두 포함하고, 핵심 품질 지표의 하락을 허용할 수 있는지 결정해야 합니다. 이는 이 리뷰의 적용 제안입니다. DistiLLM은 작은 모델을 싸게 쓰기 위해, 그 모델을 가르치는 과정의 비용부터 세밀하게 나누어야 함을 보여 줍니다.
논문 출처: https://arxiv.org/abs/2402.03898v2 · 도표 라이선스: CC BY 4.0 (https://creativecommons.org/licenses/by/4.0/). 원문 도표의 내용은 변경하지 않고 주변 여백을 제외해 인용했습니다.
반응형'IT 이야기' 카테고리의 다른 글
LongLLMLingua: 1만 토큰을 줄일 때 질문부터 봐야 하는 이유 (0) 2026.10.19 LLMLingua-2: 작은 인코더로 3,003토큰을 970토큰으로 줄인 방법 (0) 2026.10.19 Layer-Condensed KV Cache 논문 리뷰: 층의 기억을 공유할 때 얻는 처리량과 학습 비용 (0) 2026.10.18 SparseGPT 논문 리뷰: 가중치 절반을 지우는 정확도와 실제 가속의 조건 (0) 2026.10.17 SmoothQuant 논문 리뷰: 활성값의 이상값을 옮겨 W8A8을 실제 속도로 잇기 (0) 2026.10.17