-
FBI-LLM 논문 리뷰: 1.01비트의 계산 범위와 처음부터 학습하는 비용IT 이야기 2026. 10. 16. 18:00
FBI-LLM은 언어모델의 큰 선형 가중치를 두 값으로 표현하면서, 무작위 초기화에서 학습할 수 있는지 묻는 연구입니다. 이름의 ‘Fully Binarized’만 보면 모델 전체가 1비트처럼 들리지만, 실제 설정은 가중치 1비트와 활성값 16비트를 결합한 W1A16입니다. 압축의 범위, 교사 모델을 쓰는 학습 비용, 정확도 손실을 함께 보아야 연구의 성과와 남은 문제가 구별됩니다.
기존 모델을 변환하는 일과 처음부터 배우는 일
이 글은 2024년 7월 공개된 arXiv v1을 대상으로 합니다. 논문은 130M·1.3B·7B 크기의 이진 모델을 만들고, 사전학습된 가중치를 가져오지 않아도 교사의 다음 토큰 확률을 따라 학습할 수 있음을 실험합니다. 여기서 처음부터라는 말은 학생 가중치의 출발점을 뜻합니다. 교사까지 아무 사전학습 없이 만든다는 뜻이나, 기존 지식과 학습 데이터에 의존하지 않는다는 뜻은 아닙니다.
일반 가중치 행렬은 많은 실수 값을 담지만 이진 행렬은 −1과 1만 가집니다. 표현 공간이 크게 좁아지므로 원래 모델의 가중치를 단순히 부호로 바꾸는 것만으로 지식을 유지하기 어렵습니다. FBI-LLM은 이 제약을 유지한 상태에서 충분히 학습하고, 정답 토큰 하나뿐 아니라 교사가 예측한 어휘 전체의 분포를 학습 신호로 제공합니다.
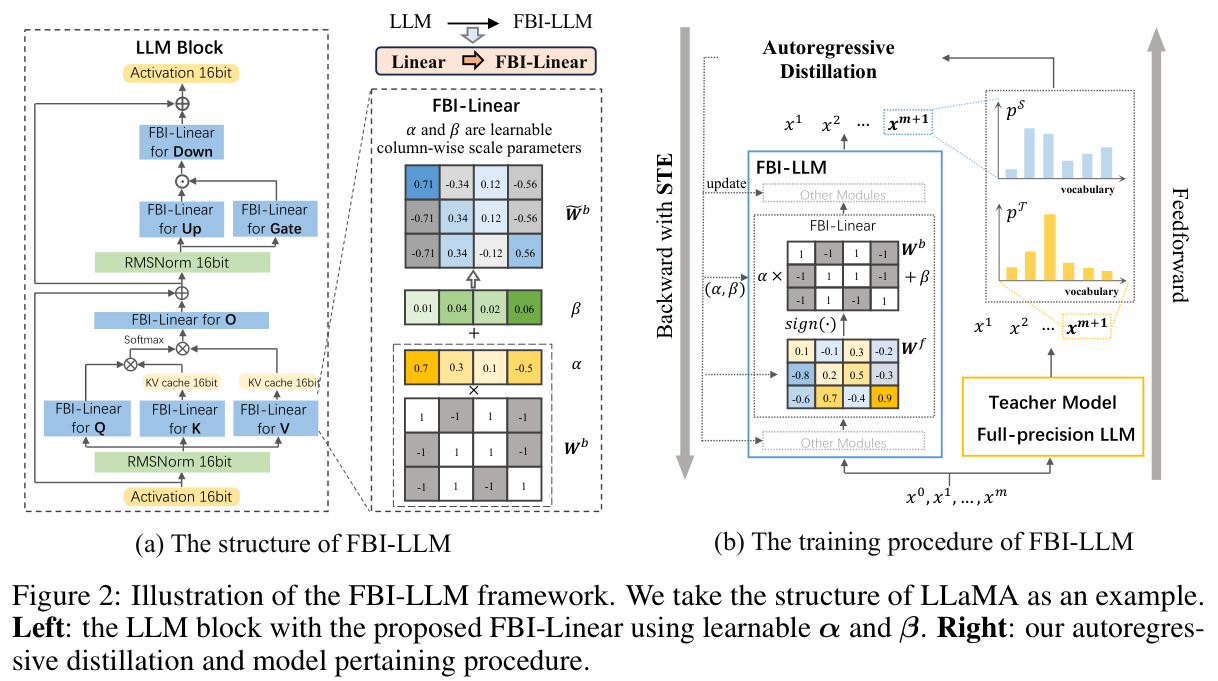
원문 Figure 2, PDF 2쪽. FBI-Linear의 이진 가중치·고정밀도 배율과 교사 모델을 이용한 자기회귀 증류 도식. 활성값 16bit 표기를 유지했다. 출처: Ma, L., Sun, M., & Shen, Z. (2024). FBI-LLM: Scaling up fully binarized LLMs from scratch via autoregressive distillation [Preprint]. arXiv. https://arxiv.org/abs/2407.07093v1 · CC BY 4.0, https://creativecommons.org/licenses/by/4.0/ · 원문 영역 캡처(여백만 제외), 내용 변경 없음. FBI-Linear에서 이진화되지 않는 부분
Figure 2에서 FBI-Linear는 이진 행렬과 열 단위의 학습 가능한 배율 α, 보정값 β를 함께 사용합니다. 따라서 실제 계산에 쓰는 가중치는 이진 부호 하나로만 정해지지 않습니다. α와 β는 고정밀도로 남아 이진화 오차를 줄입니다. 부호 함수는 미분을 그대로 통과시킬 수 없기 때문에, 학습 시에는 STE로 기울기를 근사해 전달합니다.
선형 모듈 대부분을 바꾸지만 최종 causal head는 고정밀도로 유지합니다. 임베딩과 정규화 매개변수도 예외입니다. 그림의 활성값과 KV cache 역시 16bit로 표시되어 있습니다. 가중치 파일이 작아지는 일과 긴 문맥에서 KV cache가 차지하는 메모리가 줄어드는 일은 별개입니다. 이 구조를 완전한 정수 1비트 추론 경로로 읽으면 실제 구현 범위보다 넓은 주장이 됩니다.
교사의 확률 분포를 배우는 방법
학습 시 같은 토큰 문맥을 교사와 학생에게 주고, 다음 토큰에 대한 확률 분포가 가까워지도록 교차엔트로피를 계산합니다. 정답 토큰만 알려 주는 one-hot 학습보다 다른 후보의 상대적인 가능성도 전달할 수 있습니다. 이 논문은 여러 손실을 덧붙이기보다 자기회귀 증류 손실 하나를 사용하는 단순한 학습 구성을 제안합니다.
이는 학습 절차를 단순화하는 선택이지 교사 계산을 없애는 선택은 아닙니다. 모든 학생 크기에서 교사는 LLaMA2-7B이며, 학습 정밀도는 BF16입니다. 추론 때 저장할 이진 가중치와 학습 때 유지하는 실수 가중치·기울기·교사의 계산을 구별해야 합니다. 1비트 모델을 만드는 과정까지 1비트 자원만 사용한다고 볼 수 없는 이유입니다.
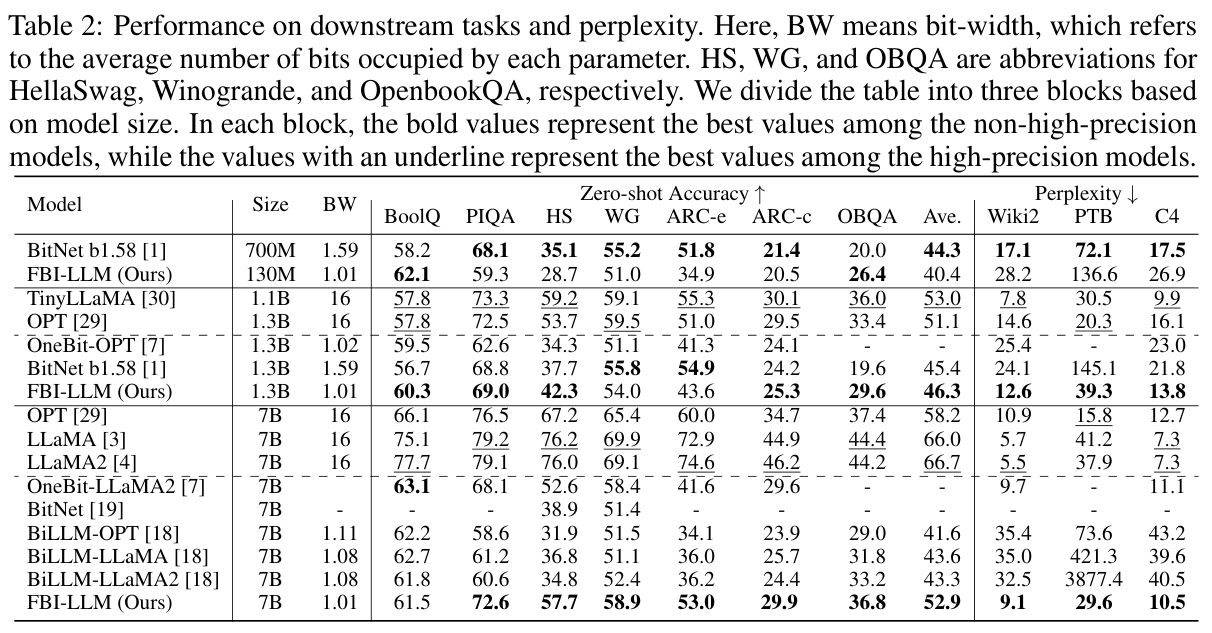
원문 Table 2, PDF 6쪽. Zero-shot Accuracy는 높을수록, Perplexity는 낮을수록 좋다. BW는 임베딩·헤드를 제외한 평균 비트 수. 원문 약어와 캡션 전체를 보존했다. 출처: Ma, L., Sun, M., & Shen, Z. (2024). FBI-LLM: Scaling up fully binarized LLMs from scratch via autoregressive distillation [Preprint]. arXiv. https://arxiv.org/abs/2407.07093v1 · CC BY 4.0, https://creativecommons.org/licenses/by/4.0/ · 원문 영역 캡처(여백만 제외), 내용 변경 없음. 무엇을 평가했고 어떤 모델과 비교했는가
학습 데이터는 RefinedWeb·StarCoder·RedPajama-v1이 섞인 Amber입니다. 전체는 1.26조 토큰, 360개 chunk로 구성되지만, 논문의 7B 결과는 31개 chunk, 약 8.6%를 사용한 시점입니다. 전체 데이터가 공개되어 있다는 사실과 보고된 모델이 그 전체를 학습했다는 사실은 다릅니다. 최대 문맥 길이는 2,048이며 모델별 배치 토큰 수도 다릅니다.
평가는 BoolQ, PIQA, HellaSwag, WinoGrande, ARC-Easy, ARC-Challenge, OpenBookQA의 일곱 zero-shot 과제와 WikiText2·PTB·C4 perplexity를 사용합니다. 과제 정확도는 높을수록, perplexity는 낮을수록 좋습니다. 일부 비교군에는 평가 결과가 빠져 있고, BitNet b1.58은 저자 원본 모델 대신 제3자 공개 모델로 일부 지표를 평가했다는 각주도 있습니다. 이름이 같은 방법이라도 이 출처 차이는 비교의 한계입니다.
평균 52.9점은 무엇과의 격차인가
Table 2의 FBI-LLM 1.3B는 평균 정확도 46.3입니다. 같은 크기 OPT-1.3B의 51.1보다 4.8%포인트 낮고, 이진 계열 비교군 BitNet b1.58 1.3B의 45.4보다 0.9%포인트 높습니다. 그러나 과제별로는 일괄 우세하지 않습니다. 예를 들어 ARC-Easy에서는 FBI-LLM 43.6과 BitNet b1.58 54.9로 평균의 순서와 다릅니다.
7B FBI-LLM의 평균 정확도는 52.9이며, FP16 OPT-7B는 58.2, LLaMA2-7B는 66.7입니다. 따라서 LLaMA2와의 차이는 13.8%포인트로 남습니다. 같은 표의 WikiText2 perplexity도 FBI-LLM 9.1, LLaMA2 5.5입니다. 일부 이진 비교군보다 좋은 결과를 얻었다는 결론과 고정밀도 모델을 손실 없이 대체했다는 결론은 명확히 구별해야 합니다.
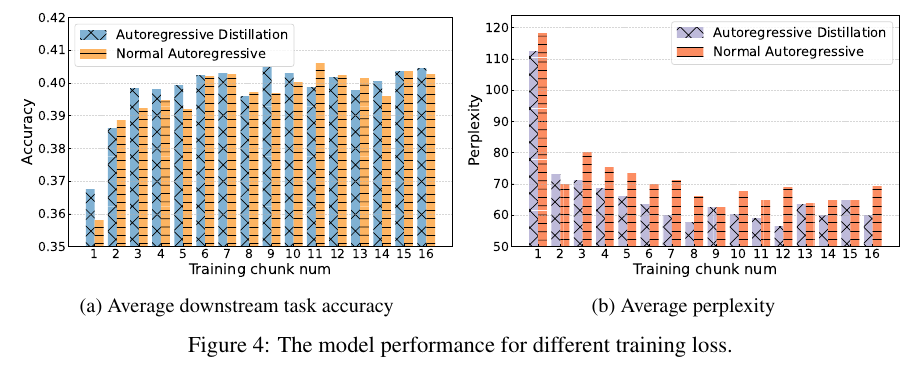
원문 Figure 4, PDF 7쪽. 두 패널의 가로축은 학습 데이터 청크 1~16이다. 왼쪽 세로축은 상식 과제 평균 정확도(0~1, 높을수록 좋음), 오른쪽은 평균 perplexity(낮을수록 좋음)다. 자기회귀 증류와 표준 학습을 비교한다. 출처: Ma, L., Sun, M., & Shen, Z. (2024). FBI-LLM: Scaling up fully binarized LLMs from scratch via autoregressive distillation [Preprint]. arXiv. https://arxiv.org/abs/2407.07093v1 · CC BY 4.0, https://creativecommons.org/licenses/by/4.0/ · 원문 영역 캡처(여백만 제외), 내용 변경 없음. 증류 손실의 효과는 어떻게 확인했는가
Figure 4는 다른 학습 절차를 같게 두고 자기회귀 증류와 일반 자기회귀 손실을 비교합니다. 가로축은 사용한 학습 chunk 수이고, 세로축은 평균 정확도 또는 평균 perplexity입니다. 논문에 제시된 구간에서 증류 모델의 정확도가 높고 perplexity가 낮게 나타납니다. 교사의 soft label을 쓰는 선택이 유효하다는 직접적인 근거입니다.
다만 이 그래프는 모든 모델 크기와 모든 데이터 분포의 개선 폭을 보장하지 않습니다. 그래프의 소수 정확도 0.40은 40% 수준이며, perplexity 축과 수치 크기를 직접 비교할 수도 없습니다. 학습 초기화 방식의 분석 역시 특정 기반 모델과 관찰 구간의 결과입니다. ‘사전학습 가중치는 언제나 불필요하다’는 보편 명제로 확장하는 대신, 이진 모델에서 다른 학습 경로가 가능함을 보인 결과로 읽는 편이 적절합니다.
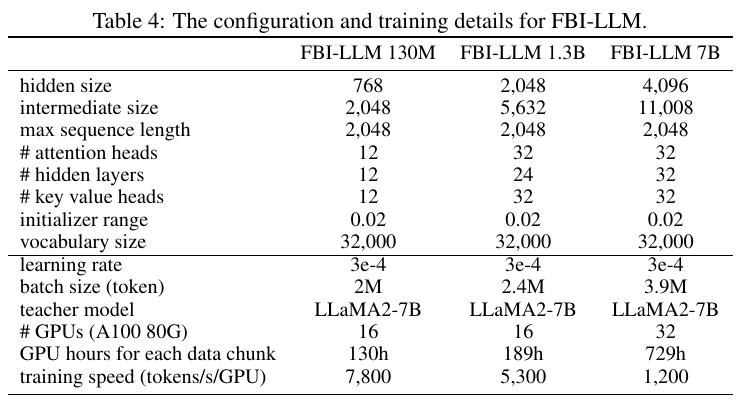
원문 Table 4, PDF 13쪽. 모델 크기별 GPU 수, GPU 한 장당 학습 처리량(tokens/s/GPU), 청크당 GPU 시간. A100 80GB에서의 학습 비용이며 추론 처리량이 아니다. 출처: Ma, L., Sun, M., & Shen, Z. (2024). FBI-LLM: Scaling up fully binarized LLMs from scratch via autoregressive distillation [Preprint]. arXiv. https://arxiv.org/abs/2407.07093v1 · CC BY 4.0, https://creativecommons.org/licenses/by/4.0/ · 원문 영역 캡처(여백만 제외), 내용 변경 없음. 1.01비트와 GPU 비용의 분모
Table 2의 평균 비트 수 BW는 임베딩과 head를 제외합니다. 부록 B의 계산은 이진 행렬에 더해 정규화와 α·β의 16비트 비용을 포함하지만, 제외한 두 큰 모듈까지 모델 전체 1.01비트로 환산하지는 않습니다. 실제 메모리 예산에는 이진 가중치 외에 이 예외 모듈, KV cache, 활성값, 실행 중 작업 공간을 별도로 고려해야 합니다.
부록 Table 4는 130M·1.3B·7B에 각각 A100 80GB 16·16·32장을 배정합니다. 본문의 64 GPU는 이 구성을 합친 수이며 각 모델이 모두 64장을 썼다는 뜻이 아닙니다. 7B는 chunk당 729 GPU시간, GPU당 학습 처리 속도는 1,200 tokens/s로 보고합니다. GPU시간은 GPU 수를 고려한 자원량이고, 그 숫자를 곧바로 벽시계 시간이나 사용자 요청의 추론 처리량으로 읽어서는 안 됩니다.
도입 가능성과 아직 남은 조건
저자들은 이진화의 정확도 손실, 증류가 더하는 계산 비용, 현재 하드웨어에서 실제 가속을 얻기 어렵다는 문제를 한계로 명시합니다. 중간 활성값의 이진화도 다루지 않았습니다. 학습 중에는 손실이 급증하면 이전 checkpoint로 돌아가 문제 chunk를 건너뛰는 대응도 사용합니다. 단순한 손실 함수라는 장점이 학습 운영까지 항상 간단하다는 뜻은 아닙니다.
실무 판단에서는 저장 용량이 가장 큰 제약인지, 긴 문맥의 메모리인지, 응답 지연인지부터 나눌 필요가 있습니다. 이어 필요한 과제에서 고정밀도 기준과의 차이를 측정하고, 이진 연산을 실제로 활용할 하드웨어·커널을 확인해야 합니다. 이는 이 리뷰의 적용 제안입니다. FBI-LLM이 보여 준 것은 극단적인 가중치 압축에서도 학습 경로를 설계할 수 있다는 가능성이며, 1비트라는 이름 하나로 정확도·학습비·추론속도를 모두 해결했다는 결론은 아닙니다.
논문 출처: https://arxiv.org/abs/2407.07093v1 · 도표 라이선스: CC BY 4.0 (https://creativecommons.org/licenses/by/4.0/). 원문 도표의 내용은 변경하지 않고 주변 여백을 제외해 인용했습니다.
반응형'IT 이야기' 카테고리의 다른 글
SparseGPT 논문 리뷰: 가중치 절반을 지우는 정확도와 실제 가속의 조건 (0) 2026.10.17 SmoothQuant 논문 리뷰: 활성값의 이상값을 옮겨 W8A8을 실제 속도로 잇기 (0) 2026.10.17 EfficientQAT 논문 리뷰: 2비트 정확도를 회복하는 두 단계와 41시간의 조건 (0) 2026.10.16 Gemma 2 논문 리뷰: ‘2B’라는 이름만으로 sLLM을 고르면 놓치는 것 (1) 2026.10.15 MobiLlama 논문 리뷰: 5억 파라미터를 만드는 다른 방법, FFN 공유 (0) 2026.10.15