-
Gemma 2 논문 리뷰: ‘2B’라는 이름만으로 sLLM을 고르면 놓치는 것IT 이야기 2026. 10. 15. 18:00
작은 언어모델을 고를 때는 파라미터 수와 평균 점수부터 보게 됩니다. Gemma 2 논문은 여기에 질문 하나를 더합니다. 작은 모델이 학습할 때 받은 정보는 얼마나 풍부했을까요? 이 글은 2024년 논문의 v3를 기준으로, 2B 모델을 중심에 놓고 증류의 효과와 실제 선택 기준을 살펴봅니다. 현재 모델 순위를 매기거나 특정 기기에서의 실행 성능을 검증한 글은 아닙니다.
정답 하나보다 풍부한 학습 신호
일반적인 다음 토큰 학습은 실제 등장한 토큰을 맞히도록 합니다. 지식 증류는 큰 교사 모델이 여러 후보 토큰에 부여한 확률 분포를 작은 학생 모델이 배우게 합니다. 정답뿐 아니라 후보들 사이의 상대적인 가능성도 전달하는 셈입니다. Gemma 2는 2B와 9B 사전학습에 이 방식을 적용했고, 27B는 증류 없이 학습했습니다. 2B의 학습량은 2조 토큰입니다. 작은 모델이라고 학습 과정까지 가볍다는 뜻은 아닙니다.
원문의 Table 6은 효과를 분리해 보는 실험입니다. 2B 모델을 5,000억 토큰으로 학습할 때, 처음부터 학습한 조건의 세 벤치마크 평균은 60.3, 7B 교사에서 증류한 조건은 67.7입니다. 차이는 7.4점입니다. 여기서 67.7을 출시된 2B 모델의 종합 성적이라고 읽으면 안 됩니다. 이 표는 학습량과 교사 크기가 정해진 별도 비교 실험이며, 표 자체는 평균을 구성한 세 벤치마크의 이름을 밝히지 않습니다. 모든 과제에서 같은 폭으로 좋아졌다는 결론도 이 평균만으로는 낼 수 없습니다.
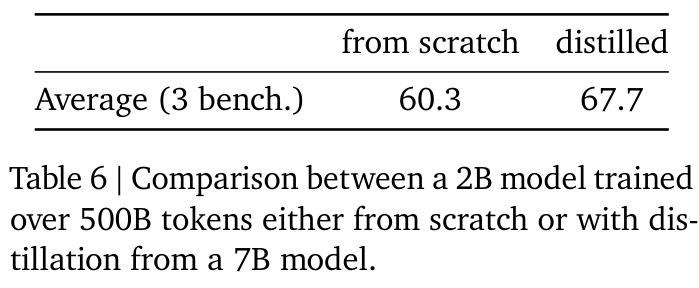
그림 1. Gemma Team, Google DeepMind (2024), Table 6, p. 5. 출처: https://arxiv.org/pdf/2408.00118v3#page=5. 논문 라이선스: CC BY 4.0 (https://creativecommons.org/licenses/by/4.0/). © 2024 Google DeepMind. 변경: 원문 표와 캡션 영역을 발췌하고 PNG로 변환·확대; 수치·행·열·주석 수정 없음. 저자의 보증이나 지지를 뜻하지 않음.
Table 6 수치 읽기
2B 모델 · 학습량 500B 토큰 · 7B 교사 증류와 처음부터 학습한 조건의 비교입니다. Average (3 bench.): from scratch 60.3, distilled 67.7. 세 벤치마크의 이름은 이 표에 적혀 있지 않습니다.
‘2B’와 실제 메모리 예산은 다릅니다
Table 2는 임베딩과 나머지 파라미터를 나눠 보여줍니다. 2B 모델의 임베딩은 590,118,912개, 비임베딩은 2,024,517,888개로, 합하면 약 26.15억 개입니다. 어휘 임베딩까지 포함하면 이름보다 커집니다. 여러 모델을 비교할 때 총 파라미터와 비임베딩 파라미터를 섞지 않아야 하는 이유입니다.
예를 들어 모든 가중치를 16비트로 저장한다고 가정하면, 이 합계에 2바이트를 곱한 값은 약 5.23GB입니다. 이는 가중치만 단순 계산한 값으로, 실행에 필요한 메모리 측정치가 아닙니다. KV 캐시, 중간 계산, 실행 도구의 추가 메모리가 더 필요합니다. 양자화 방식에 따라서도 달라집니다. 논문에 나온 구조나 숫자를 휴대전화·노트북의 실행 보장으로 바꾸어 말해서는 안 됩니다.

그림 2. Gemma Team, Google DeepMind (2024), Table 2, p. 2. 출처: https://arxiv.org/pdf/2408.00118v3#page=2. 논문 라이선스: CC BY 4.0 (https://creativecommons.org/licenses/by/4.0/). © 2024 Google DeepMind. 변경: 원문 표와 캡션 영역을 발췌하고 PNG로 변환·확대; 수치·행·열·주석 수정 없음. 저자의 보증이나 지지를 뜻하지 않음.
Table 2 수치 읽기
2B
임베딩 파라미터: 590,118,912개; 비임베딩 파라미터: 2,024,517,888개9B
임베딩 파라미터: 917,962,752개; 비임베딩 파라미터: 8,324,201,984개27B
임베딩 파라미터: 1,180,237,824개; 비임베딩 파라미터: 26,047,480,320개원문 캡션의 조건: 여러 언어를 다루도록 설계된 Gemini의 큰 어휘(256k entries)를 사용하므로, 한두 언어에 제한된 모델보다 임베딩 파라미터 수가 큽니다. 이것이 특정 언어의 성능을 보장하지는 않습니다.
평균이 좋아도 내 작업은 나빠질 수 있습니다
Table 13의 사전학습 모델 비교에서 Gemma 1 2B와 Gemma 2 2B의 MMLU는 42.3에서 52.2로, GSM8K는 15.1에서 24.3으로 올라갑니다. 그러나 코드 생성 평가 HumanEval의 pass@1은 22.0에서 20.1로 내려갑니다. 지식·추론 평균 개선을 곧바로 코드 작성 품질 개선이라고 해석할 수 없습니다. pass@1은 한 번 생성했을 때 정답일 확률을 추정하는 지표입니다.
이 표를 읽는 순서는 ‘작업에 맞는 행 → 평가 방법 → 점수’가 좋습니다. MMLU는 5-shot, GSM8K도 5-shot이고, DROP은 F1을 씁니다. 서로 다른 평가 지표를 한 종류의 정답률처럼 취급하지 않습니다. 표의 †와 ◇ 주석은 일부 비교 모델에 다른 평가 방식을 적용했음을 설명합니다. 따라서 작은 차이로 모델 우열을 확정하기보다, 같은 프롬프트와 채점 방식으로 다시 비교할 후보를 좁히는 근거로 쓰는 편이 타당합니다.
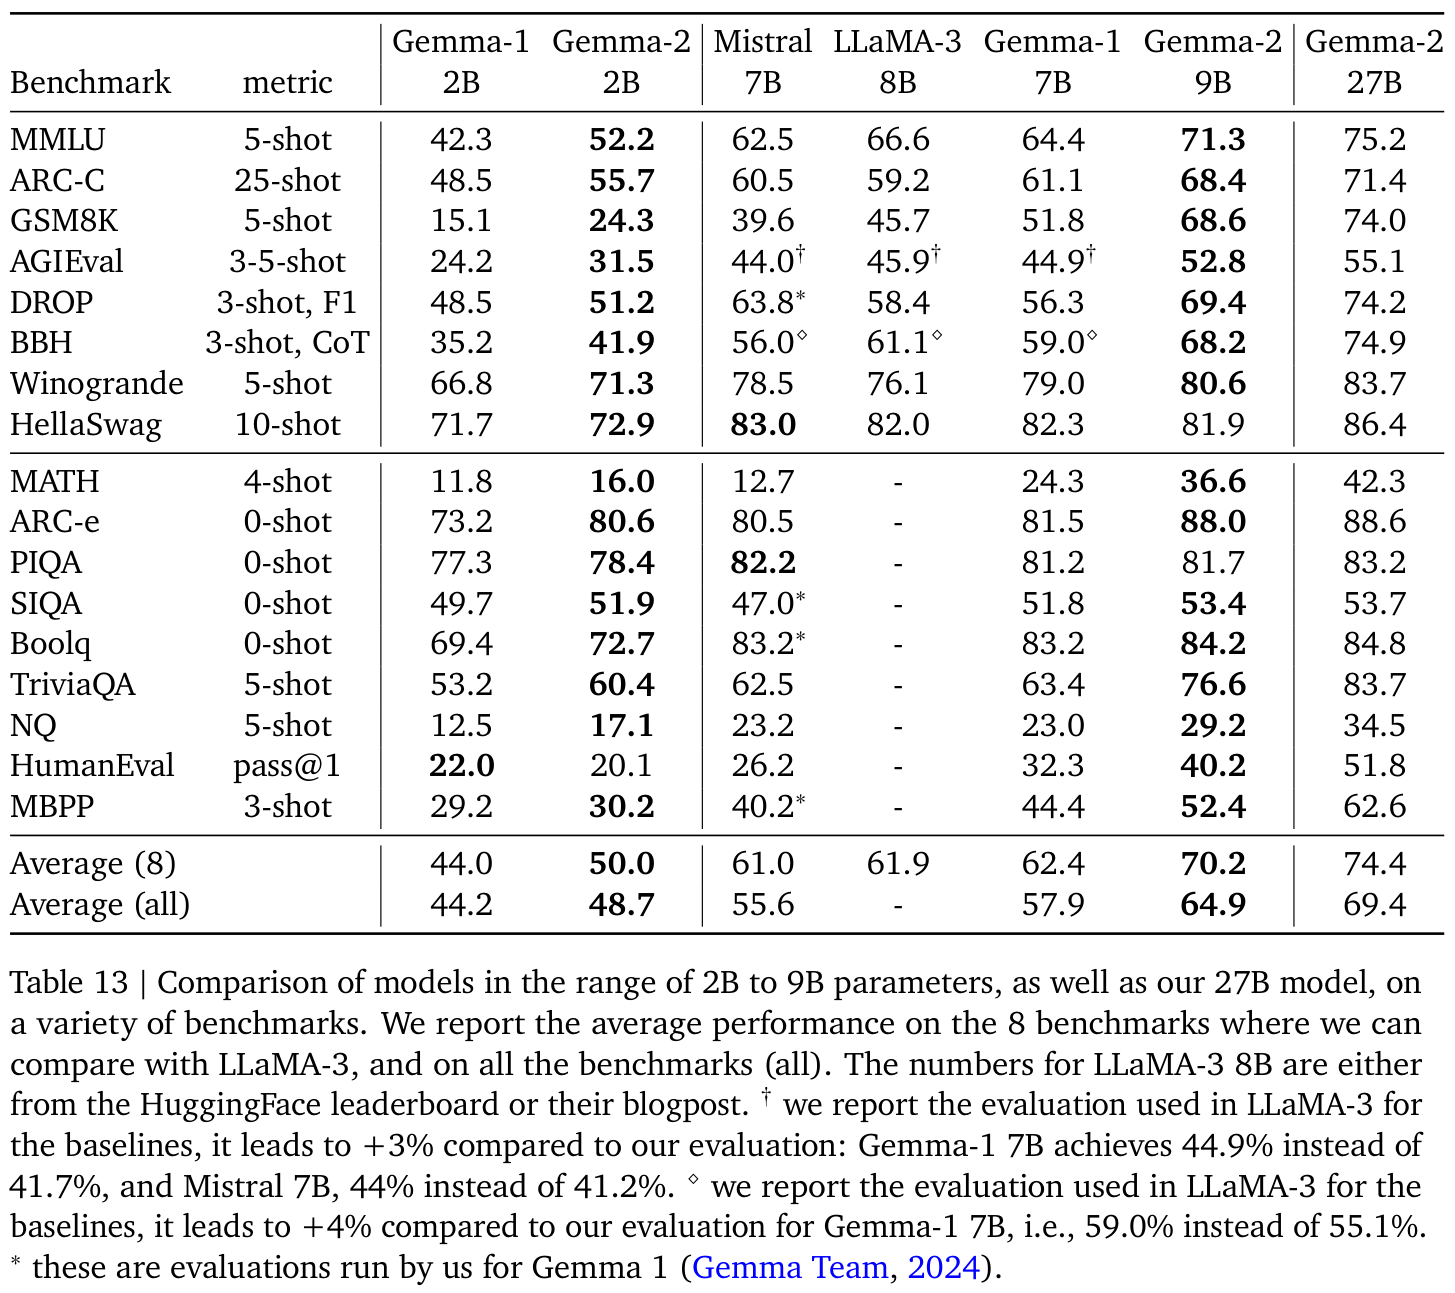
그림 3. Gemma Team, Google DeepMind (2024), Table 13, p. 7. 출처: https://arxiv.org/pdf/2408.00118v3#page=7. 논문 라이선스: CC BY 4.0 (https://creativecommons.org/licenses/by/4.0/). © 2024 Google DeepMind. 변경: 원문 표와 캡션 영역을 발췌하고 PNG로 변환·확대; 수치·행·열·주석 수정 없음. 저자의 보증이나 지지를 뜻하지 않음.
Table 13 수치 읽기
같은 표의 모든 행을 평가 조건과 함께 옮겼습니다. 사전학습형 모델 비교이며, 서로 다른 지표를 한 종류의 정답률로 합치지 않습니다. –는 원문에서 결과가 없는 칸입니다. Average (8)은 LLaMA-3와 비교할 수 있는 여덟 벤치마크, Average (all)은 전체 벤치마크 평균입니다.
MMLU 5-shot
Gemma-1 2B: 42.3; Gemma-2 2B: 52.2; Mistral 7B: 62.5
LLaMA-3 8B: 66.6; Gemma-1 7B: 64.4; Gemma-2 9B: 71.3
Gemma-2 27B: 75.2ARC-C 25-shot
Gemma-1 2B: 48.5; Gemma-2 2B: 55.7; Mistral 7B: 60.5
LLaMA-3 8B: 59.2; Gemma-1 7B: 61.1; Gemma-2 9B: 68.4
Gemma-2 27B: 71.4GSM8K 5-shot
Gemma-1 2B: 15.1; Gemma-2 2B: 24.3; Mistral 7B: 39.6
LLaMA-3 8B: 45.7; Gemma-1 7B: 51.8; Gemma-2 9B: 68.6
Gemma-2 27B: 74.0AGIEval 3-5-shot
Gemma-1 2B: 24.2; Gemma-2 2B: 31.5; Mistral 7B: 44.0†
LLaMA-3 8B: 45.9†; Gemma-1 7B: 44.9†; Gemma-2 9B: 52.8
Gemma-2 27B: 55.1DROP 3-shot, F1
Gemma-1 2B: 48.5; Gemma-2 2B: 51.2; Mistral 7B: 63.8∗
LLaMA-3 8B: 58.4; Gemma-1 7B: 56.3; Gemma-2 9B: 69.4
Gemma-2 27B: 74.2BBH 3-shot, CoT
Gemma-1 2B: 35.2; Gemma-2 2B: 41.9; Mistral 7B: 56.0⋄
LLaMA-3 8B: 61.1⋄; Gemma-1 7B: 59.0⋄; Gemma-2 9B: 68.2
Gemma-2 27B: 74.9Winogrande 5-shot
Gemma-1 2B: 66.8; Gemma-2 2B: 71.3; Mistral 7B: 78.5
LLaMA-3 8B: 76.1; Gemma-1 7B: 79.0; Gemma-2 9B: 80.6
Gemma-2 27B: 83.7HellaSwag 10-shot
Gemma-1 2B: 71.7; Gemma-2 2B: 72.9; Mistral 7B: 83.0
LLaMA-3 8B: 82.0; Gemma-1 7B: 82.3; Gemma-2 9B: 81.9
Gemma-2 27B: 86.4MATH 4-shot
Gemma-1 2B: 11.8; Gemma-2 2B: 16.0; Mistral 7B: 12.7
LLaMA-3 8B: -; Gemma-1 7B: 24.3; Gemma-2 9B: 36.6
Gemma-2 27B: 42.3ARC-e 0-shot
Gemma-1 2B: 73.2; Gemma-2 2B: 80.6; Mistral 7B: 80.5
LLaMA-3 8B: -; Gemma-1 7B: 81.5; Gemma-2 9B: 88.0
Gemma-2 27B: 88.6PIQA 0-shot
Gemma-1 2B: 77.3; Gemma-2 2B: 78.4; Mistral 7B: 82.2
LLaMA-3 8B: -; Gemma-1 7B: 81.2; Gemma-2 9B: 81.7
Gemma-2 27B: 83.2SIQA 0-shot
Gemma-1 2B: 49.7; Gemma-2 2B: 51.9; Mistral 7B: 47.0∗
LLaMA-3 8B: -; Gemma-1 7B: 51.8; Gemma-2 9B: 53.4
Gemma-2 27B: 53.7Boolq 0-shot
Gemma-1 2B: 69.4; Gemma-2 2B: 72.7; Mistral 7B: 83.2∗
LLaMA-3 8B: -; Gemma-1 7B: 83.2; Gemma-2 9B: 84.2
Gemma-2 27B: 84.8TriviaQA 5-shot
Gemma-1 2B: 53.2; Gemma-2 2B: 60.4; Mistral 7B: 62.5
LLaMA-3 8B: -; Gemma-1 7B: 63.4; Gemma-2 9B: 76.6
Gemma-2 27B: 83.7NQ 5-shot
Gemma-1 2B: 12.5; Gemma-2 2B: 17.1; Mistral 7B: 23.2
LLaMA-3 8B: -; Gemma-1 7B: 23.0; Gemma-2 9B: 29.2
Gemma-2 27B: 34.5HumanEval pass@1
Gemma-1 2B: 22.0; Gemma-2 2B: 20.1; Mistral 7B: 26.2
LLaMA-3 8B: -; Gemma-1 7B: 32.3; Gemma-2 9B: 40.2
Gemma-2 27B: 51.8MBPP 3-shot
Gemma-1 2B: 29.2; Gemma-2 2B: 30.2; Mistral 7B: 40.2∗
LLaMA-3 8B: -; Gemma-1 7B: 44.4; Gemma-2 9B: 52.4
Gemma-2 27B: 62.6Average (8)
Gemma-1 2B: 44.0; Gemma-2 2B: 50.0; Mistral 7B: 61.0
LLaMA-3 8B: 61.9; Gemma-1 7B: 62.4; Gemma-2 9B: 70.2
Gemma-2 27B: 74.4Average (all)
Gemma-1 2B: 44.2; Gemma-2 2B: 48.7; Mistral 7B: 55.6
LLaMA-3 8B: -; Gemma-1 7B: 57.9; Gemma-2 9B: 64.9
Gemma-2 27B: 69.4원문 주석: LLaMA-3 8B의 값은 HuggingFace 리더보드 또는 해당 블로그에서 가져왔습니다. †는 기준 모델에 LLaMA-3에서 사용한 평가를 적용한 값입니다. 논문 자체 평가와 비교해 약 +3%이며, Gemma-1 7B는 41.7% 대신 44.9%, Mistral 7B는 41.2% 대신 44%입니다. ◇(원문 ⋄)도 LLaMA-3 평가 방식을 적용한 값이며, Gemma-1 7B는 55.1% 대신 59.0%로 약 +4%입니다. *(원문 ∗)는 저자들이 Gemma 1을 위해 실행한 평가입니다(Gemma Team, 2024). 이 주석과 수치 차이는 평가 방법의 차이이며, 동일 조건의 개선률로 읽지 않습니다.
도입 전에 확인할 네 가지
아래는 논문의 실험 결과가 아니라, 결과를 활용하기 위한 실무 제안입니다.
- 작업: 요약, 분류, 코드 생성 중 실제 업무를 정하고 대표 입력과 실패 사례를 준비합니다. 평균 점수보다 해당 작업의 오류를 봅니다.
- 모델: 사전학습형과 지시학습형을 구분합니다. Table 13의 수치를 채팅용 모델의 결과로 옮겨 쓰지 않습니다.
- 환경: 기기, 실행 도구, 양자화, 입력 길이를 고정하고 메모리 사용량과 응답 시간을 직접 기록합니다. 점수와 속도는 별도 항목으로 판단합니다.
- 언어·안전: 한국어 사실성, 출력 형식, 개인정보 노출, 부적절한 답변을 별도로 시험합니다. 학생 자료를 평가에 쓴다면 먼저 비식별화하고 기관의 처리 기준을 확인합니다.
논문은 학습 데이터가 주로 영어이며 다국어 최고 성능을 목표로 학습하지 않았다고 밝힙니다. 이 글에서 한국어 성능이나 교육 효과를 추정하지 않는 이유입니다. 교실에서의 사용 여부도 벤치마크만으로 결정할 수 없습니다. 핵심은 ‘작아서 좋은 모델’을 찾는 데서 멈추지 않고, 필요한 작업의 품질을 확인한 뒤 실제 자원 예산과 안전 조건 안에 들어오는지 판단하는 것입니다.
참고문헌
Gemma Team. (2024). Gemma 2: Improving open language models at a practical size (Version 3) [Preprint]. arXiv. https://doi.org/10.48550/arXiv.2408.00118
검토 기준: arXiv v3, 2024년 10월 2일 수정본. 자료 확인: 2026년 10월 14일. 논문 첫 장에는 2024년 6월 27일이 표시되어 있어 저장소의 수정일과 구분했습니다. 모델 가중치 이용 조건과 논문 그림·표 재사용 라이선스는 별개입니다.
반응형'IT 이야기' 카테고리의 다른 글
FBI-LLM 논문 리뷰: 1.01비트의 계산 범위와 처음부터 학습하는 비용 (0) 2026.10.16 EfficientQAT 논문 리뷰: 2비트 정확도를 회복하는 두 단계와 41시간의 조건 (0) 2026.10.16 MobiLlama 논문 리뷰: 5억 파라미터를 만드는 다른 방법, FFN 공유 (0) 2026.10.15 MiniCPM 논문 리뷰: 작은 모델은 학습을 어떻게 마무리하느냐에 달렸다 (0) 2026.10.14 Phi-3 논문 리뷰: 3.8B 모델은 무엇을 배우고, 무엇을 놓쳤을까? (0) 2026.10.14